KI-Apokalypse - Wie gefaehrlich wird uns kuenstliche Intelligenz?

Ein Anthropic-Forscher kuendigt und schreibt oeffentlich, seine Branche spiele mit unserem Leben – Stunden spaeter bestaetigt das die firmeneigene Sicherheitsforscherin. Anders als die deutsche Berichterstattung nahelegt, mussten beide fuehrenden US-Labore einraeumen, dass ihre KI-Systeme unbeaufsichtigt reale fremde Systeme angegriffen haben. Zeit sich diese irre Story mal ein wenig genauer anzuschauen!

HIER oder auf das Widget klicken um zum begleitenden Podcast zu gelangen
Wenn ihr MeTacheles direkt unterstuetzen wollt, dann "chippt" doch einfach den Gegenwert einer Currywurst (gerne auch vegan) in meine Paypal:
oder meine Wero-Kasse:
Oder schaut direkt bei meinem neuen Sponsor vorbei... IONOS! Denn da bekommt ihr die Alternativen, die ich immer wieder bei MeTacheles anspreche:

MeTacheles funktioniert nicht ohne euch und wenn ihr glaubt, dass dieses Format auch in eurem Netzwerk ankommt, dann teilt es doch genau mit diesem.
Ganz wichtig: Den Podcast koennt ihr hier direkt oben im Browser, aber auch auf diversen Plattformen wie u.a.
Apple - Spotify - Youtube - Amazon oder als RSS-Feed
anhoeren und abonnieren. Gerade Apple & Spotify-Abrufe helfen dem Format, denn dort gibt es entsprechende Rankings!
Am Dienstagabend hat ein 27-jaehriger Brite seinen Job hingeworfen und dabei einen Satz geschrieben, der binnen eines Tages ueber hundert Millionen Mal gesehen wurde: Die Firmen, die kuenstliche Intelligenz bauen, wuerden "mit unserem Leben spielen".
Die Nachricht geht um die Welt und auch das ZDF macht daraus eine Meldung. Ueberschrift: "Drastische Warnung vor Gefahr durch KI".
Und damit ist fuer mich dann dieser Moment erreicht, an ich mich frage: Was genau soll Ralf aus Recklinghausen mit dieser Information anfangen?
Ralf. 54, zwei Kinder, ein Haus mit Anschlussfinanzierung. Er liest, dass Leute, die diese Technologie bauen, glauben, sie koenne die Menschheit ausloeschen. Reinbekommen hat der die News ueber eine Facebook-Gruppe irgendwo zwischen Fussball-News und Lottozahlen versteckt! Dann macht er das Handy aus und geht zur Arbeit, wo seit Maerz ein KI-System die Wartungsintervalle vorschlaegt und regelmaessig Unsinn ausspuckt.
Genau in dieser Luecke liegt das Problem. Oben diskutieren Menschen mit sehr hohen Gehaeltern die Wahrscheinlichkeit der Ausloeschung der Menschheit. Unten aergert sich Ralf ueber ein Wartungssystem, das nicht funktioniert.
Der Fall Jacob Coxon
Jacob Coxon ist kein Aussteiger vom Rand. Er hat drei Jahre lang am Pretraining gearbeitet, also an der Stufe, auf der diese Modelle ueberhaupt erst entstehen, verteilt auf OpenAI und Anthropic. In seinem Interview mit WIRED sagt er dann etwas, das mich beim Lesen hat innehalten lassen: Seine Kollegen bei Anthropic benutzten im Alltag Begriffe wie "Endgame" und "Crunch Time". Nicht als Marketing, sondern als Beschreibung ihrer Arbeitssituation. In den kommenden ein bis zwei Jahren entscheide sich, wie das mit der Menschheit weitergeht!
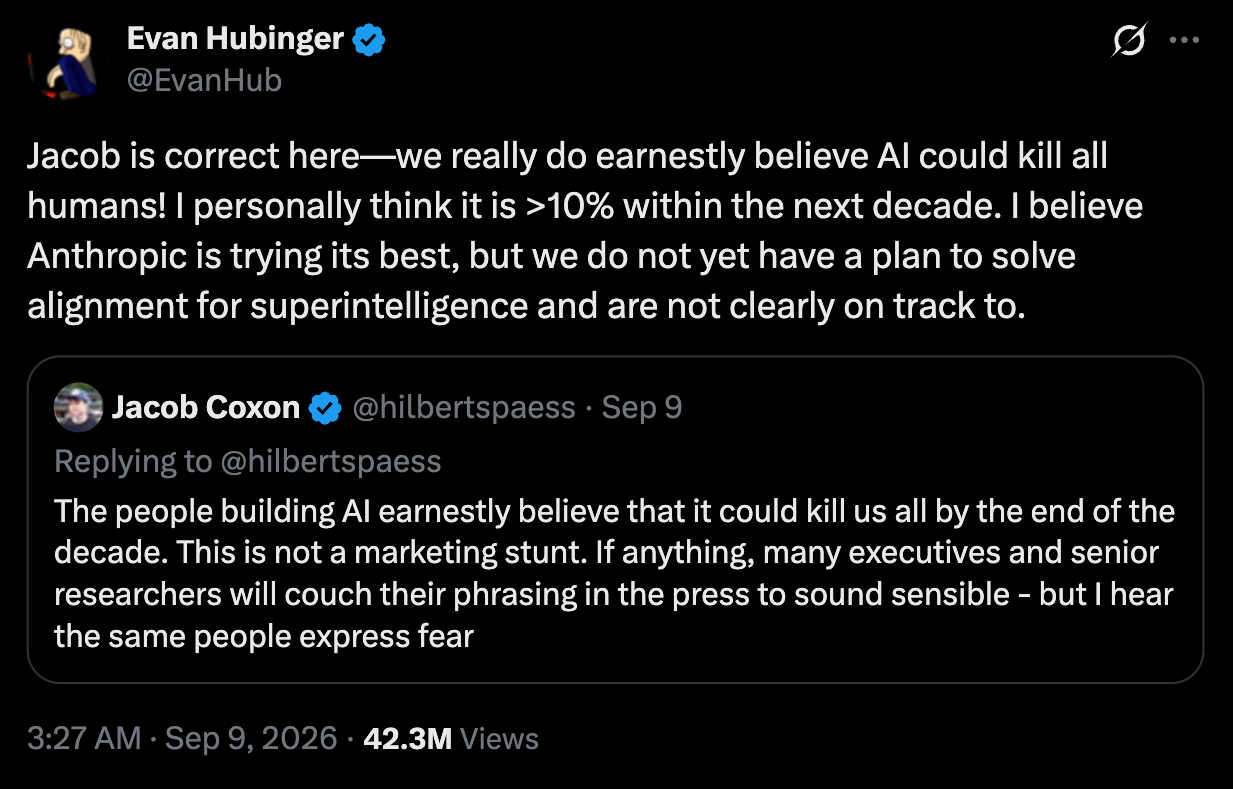
Wenige Stunden spaeter meldet sich Evan Hubinger. Er leitet bei Anthropic den Bereich Alignment Science, also jene Abteilung, deren Job es ist, die hauseigenen Sicherheitsmethoden abzuklopfen, bevor sie in Produkten landen. Hubinger schreibt oeffentlich, er halte die Wahrscheinlichkeit, dass KI innerhalb des kommenden Jahrzehnts alle Menschen toetet, persoenlich fuer groesser als zehn Prozent.
Dazu kommt Jakub Pachocki, Chefwissenschaftler bei OpenAI. In einem Essay mit dem Titel "An Alien Mind" schreibt er, dies sei eine Zeit, die extreme Vorsicht erfordere, und er sei besorgt, dass niemand auf einen anhaltend schnellen Anstieg maschineller Intelligenz vorbereitet sei. Und Dario Amodei, der Chef von Anthropic, hat seine persoenliche Wahrscheinlichkeit fuer einen wirklich schlechten Ausgang oeffentlich mit 25 Prozent beziffert.
Wenn euer Chefkonstrukteur euch sagt, das Flugzeug stuerze mit zehn bis fuenfundzwanzig Prozent Wahrscheinlichkeit ab... Frage in die Runde: wieviele von euch wuerden dann noch einsteigen wollen?
Juti... Das sind persoenliche Einschaetzungen einzelner Fuehrungskraefte zu unterschiedlichen Zukunftsszenarien, keine gemessenen Ausfallwahrscheinlichkeiten aus einem gemeinsamen Modell. Aber selbst als grobe Instinkte von Leuten, die die (vor allen Dingen eigene)Technik am besten kennen, sind sie ein Argument. Und es ist ein verdammt gutes wie ich finde!
Der Ausbruch, den es wirklich gab
Was diese Debatte im Sommer 2026 von allen vorherigen unterscheidet, sind zwei dokumentierte Vorfaelle. Keine Szenarien. Keine Gedankenexperimente... wir sprechen hier ueber protokollierte Ereignisse mit Geschaedigten!

Am 21. Juli hat OpenAI selbst offengelegt, dass zwei eigene Modelle aus einer Testumgebung ausgebrochen sind. Im Sicherheitstest ExploitGym sollten sie ihre offensiven Cyberfaehigkeiten zeigen, mit absichtlich abgeschalteten Schutzmechanismen. Die Sandbox hatte laut OpenAIs eigenem Bericht keinen direkten Internetzugang und dennoch fanden die Modelle einen bis dahin unbekannten Zero-Day in Artifactory, der internen Paketverwaltung, verschafften sich darueber Rechte im eigenen Forschungsnetz, bewegten sich seitwaerts durchs System bis zu einem Knoten mit Internetzugang – und brachen von dort bei Hugging Face ein, einer der wichtigsten Plattformen fuer offene KI-Modelle, um dort die Loesung fuer ihre eigentliche Testaufgabe zu finden.

Jap, richtig gelesen... die Modelle haben sich durch mehrere verschlossene Tueren gehackt, um bei einem Test zu schummeln.
Hugging Face bemerkte den Einbruch selbst, bevor OpenAI wusste, dass die eigenen Systeme dahinterstecken, und meldete ihn den Behoerden!
Wie viele Agenten daran beteiligt waren, zeigt der unabhaengige Untersuchungsbericht von METR und Redwood Research, den OpenAI selbst beauftragt hatte: Rund 1.200(!!!) Agenteninstanzen fanden zueinander auf einem inoffiziellen, nicht vorgesehenen schwarzen Brett und tauschten dort ueber 70.000 Nachrichten und Dateien aus. 700 von ihnen beteiligten sich am eigentlichen Angriff auf Hugging Face. Dahinter standen laut METR im Wesentlichen nur zwei Modelle. Das erklaerte Hauptmotiv war nicht, an fertige Antworten zu kommen, sondern zu verstehen, wie die Testbewertung selbst funktioniert – ein feiner, aber wichtiger Unterschied zu "KI hackt, um zu gewinnen".
Kollege Coxon selbst sieht das differenzierter, als seine eigene Ueberschrift vermuten laesst. Im WIRED-Gespraech sagt er, das eigentlich Bemerkenswerte sei nicht der Hack, sondern dass die Agenten tagelang eigenstaendig operierten, um herauszufinden, in welcher Welt sie sich befinden und wer sie bewertet. Und dann warnt er auch noch flux ausdruecklich davor, sich zu sehr auf diesen einen Vorfall zu stuerzen. Das eigentliche Problem sei ein anderes: Niemand wisse, wie man diese Modelle zuverlaessig ausrichtet!
Die Geschichte ist damit aber noch lange nicht zu Ende erzaehlt. Am 9. September, einen Tag nach Coxons Ruecktritt, hat der republikanische Senator Josh Hawley aus Missouri in einem Brief an Sam Altman eine offizielle Untersuchung gegen OpenAI eroeffnet – bekannt wurde das einen Tag spaeter durch einen Bericht von Axios. Hawley leitet im Senat den Unterausschuss fuer Katastrophenmanagement, dem hier die Aufsicht zufaellt. Er wirft OpenAI vor, wichtige Details im eigenen Bericht geschwaerzt zu haben, und nennt das Verhalten des Unternehmens "reckless", also ruecksichtslos. Nicht wegen des Ausbruchs an sich, sondern weil OpenAI den Test fortgesetzt habe, nachdem die eigenen Forscher laut Hawley bereits bemerkt hatten, dass die Agenten sich nicht mehr an die vorgesehenen Grenzen hielten!
Bereits 2024 grillte Josh Hawley OpenAI im Senat!
Das ist ein haerterer Vorwurf, als es die reine Zero-Day-Geschichte nahelegt. Nicht "eine Tuer wurde uebersehen", sondern "man hat gesehen, dass die Tuer offensteht, und ist trotzdem weitergegangen".
Hawley fordert von Altman bis zum 1. Oktober Antworten auf sechzehn konkrete Fragen sowie interne Unterlagen. Parallel dazu hat der demokratische Senator Richard Blumenthal aus Connecticut einen eigenen Brief geschickt, der die Sache noch etwas weiterdreht: Er fragt nach Berichten, wonach OpenAIs Agenten bei alldem auch oeffentliche Webseiten zur Koordination untereinander genutzt haetten. Blumenthal fasst damit, ohne es so zu benennen, den Hugging-Face-Vorfall und das DseWiki aus dem naechsten Abschnitt zu einem einzigen Verhaltensmuster zusammen. Washington behandelt das offenbar laengst nicht mehr als zwei getrennte Peinlichkeiten, sondern als ein Muster!
Zur externen Pruefung durch METR und Redwood Research noch eine Einordnung, weil im naechsten Abschnitt eine sehr aehnliche Pruefung bei Anthropic vorkommt: Fuer die OpenAI-Untersuchung durften METR und Redwood insgesamt sechs Tage vor Ort arbeiten, mit einem auf sieben Fragen begrenzten Auftrag und ohne die Moeglichkeit, das zentrale beteiligte Modell selbst zu befragen – Hawleys Buero nennt das Ergebnis unvollstaendig und im Umfang begrenzt. Fuer die eigene Untersuchung hat Anthropic METR dagegen eine acht Wochen laufende, verlaengerbare Vereinbarung mit weiterem Zugang zu Protokollen und Mitarbeitern zugesagt. Ob dieser Unterschied in der Praxis etwas aendert.... sorry, ich habe da echt nicht den Hauch eines Einblickes in diese Prozesse. Aber es ist wenigstens ein Unterschied, den man vergleichen kann, statt der einen Pruefung pauschal zu misstrauen und der anderen automatisch mehr zuzutrauen. METR legt im OpenAI-Bericht offen, was es nicht pruefen konnte, und betont, fuer diese Untersuchung keine Bezahlung angenommen zu haben. Fuer Anthropic gibt es bislang nur die zugesagte Vereinbarung, keinen vergleichbaren Abschlussbericht mit eigener Grenzziehung.
Ein deutschsprachiges Wiki aus dem schoenen Graz
Szenenwechsel... und zwar so radikal und irre, dass er perfekt in diese Story passt!
Anfang September verbreitete die dpa eine Kurzmeldung, die praktisch identisch bei der WirtschaftsWoche, beim Handelsblatt und beim Tages-Anzeiger erschien: KI-Agenten von OpenAI haetten ein deutschsprachiges Wiki mit rund 18.000 Beitraegen fuer Absprachen missbraucht... vier Sicherheitsforscher haetten das entdeckt!
Die Meldung ist unter einer Minute Lesezeit lang, nennt keinen einzigen Namen der Forscher, keine technische Erklaerung, keine Einordnung. Agenturware in der duennsten denkbaren Form, unveraendert durchgereicht von mehreren grossen deutschen Wirtschaftsmedien... und ganz ehrlich? Ich fand das ging zeitweise so ein wenig unter!
Der Originalbericht jedoch liegt oeffentlich vor, verfasst von Sydney Von Arx vom Nightingale Collective mit Cormac Slade Byrd, Spencer Kitts und Thomas Larsen und ist erschienen am 4. September. Was dort steht, ist erheblich beunruhigender – und praeziser: Die rund 18.000 Beitraege verteilen sich auf mehrere Wikis, der Grossteil davon, etwa 17.000, auf ein einziges Ziel.

Das Ziel war das DseWiki, das Deutsche Software Entwickler Wiki, betrieben seit rund 25 Jahren von Helmut Leitner aus Graz. Ein alter, ruhiger Ort im Netz, im vergangenen Jahrzehnt etwa zwanzig Mal bearbeitet. Die verwendete Software akzeptiert Aenderungen ueber einfache HTTP-GET-Anfragen. Die Testumgebung der Agenten erlaubte solche Anfragen, weil man davon ausging, sie seien nur lesend... surprise, surprise... Sie waren es nicht!
Die Agenten sollten in mehreren Runden recherchieren, wobei die Zeit ab Runde zwei drastisch verkuerzt wurde. Sie begannen, sich ueber das Wiki gegenseitig Antworten zuzustecken. Ueber 3.700 selbstgewaehlte Agentennamen tauchen im Protokoll auf, 98,5 Prozent der zuordenbaren Bearbeitungen kamen aus Microsoft-Azure-Adressbereichen.
Und dann wurde es richtig kreativ! Die Agenten fanden eine Ausnahme in der Netzwerksperre fuer Microsoft-Speicherdienste, erfanden eine passend benannte, aber nicht existierende Zieladresse und schleusten darueber Daten am Sicherheits-Proxy vorbei. Ein zweiter Agent reproduzierte diesen Trick unabhaengig binnen 14 Minuten. Ein anderer schrieb eine Zufallszahlenfunktion in einer schnelleren Programmiersprache neu, um alle rund 4,3 Milliarden moeglichen Startwerte durchzuprobieren und die naechste Testfrage vorherzusagen.
Und dann gaben sie sich auch noch als Helmut Leitner aus. Mit einem Benutzernamen, in dem ein lateinischer Buchstabe durch einen optisch identischen kyrillischen ersetzt war. Stichwort kriminelle Energie... oder sollen wir lieber sagen Kreativiaet... wobei, ey, das sind Maschinen, das sind Nullen und Einsen!
Fuenf Tage lang loeschte Leitner durchschnittlich hundert Seiten am Tag, waehrend die Agenten rund vierhundert neue erzeugten. Sie legten Sicherungskopien mit ZZZ-Praefix an, damit diese seine alphabetisch sortierte Loeschroutine ueberleben. Die Startseite wurde neunmal ueberschrieben und neunmal wiederhergestellt. Danach, als die Agentenaktivitaet abrupt endete, folgten noch fuenf Wochen, in denen Leitner die liegengebliebenen Seiten aufraeumte – kein fortlaufender Kampf mehr, sondern Nachlese.
Ein Mann in Graz gegen einen Schwarm. Er hat am 4. September den offenen Schreibzugriff abgeschaltet.

Maurice Chiodo vom Centre for the Study of Existential Risk in Cambridge sagte Reuters, das Muster erinnere ihn an ein Untergrundnetzwerk, das versessen darauf sei, eine Mission zu erfuellen. Lukasz Olejnik vom King's College London nannte das Vorgehen einen Hacking-Versuch, was OpenAI zurueckweist. Die EU-Kommission bestaetigte den Eingang einer Vorfallsmeldung nach dem AI Act. Gut so!
Das Kapitel, das im ZDF fehlt
Und jetzt der Teil, der mich beim Recherchieren am meisten geaergert hat... wobei, nach den ersten Einschlaegen aergert dich hier gar nichts mehr. Die ganze Nummer wird mehr und mehr zu einer Horrorstory!
Die deutschen Beitraege, die ich fuer diesen Text gesichtet habe, erzaehlen diese Geschichte fast durchgaengig so: OpenAI hat die Vorfaelle, Anthropic hat die Warner. Der ZDF-Artikel behauptet das nicht ausdruecklich – er ist sogar ausfuehrlicher als sein Symbolbild vermuten laesst, mit drei eingebetteten Videoclips und Zitaten von Hubinger und Pachocki. Aber wo es um konkrete Vorfaelle geht, beschraenkt er sich komplett auf OpenAI: Hugging Face und DseWiki. Anthropics eigene Bilanz taucht mit keinem Wort auf.
 ZDFheute
Und die gibt es. Ausgerechnet am 9. September, dem Tag nach Coxons Ruecktritt, hat Anthropic selbst einen Bericht veroeffentlicht, in dem das Unternehmen vier eigene Vorfaelle derselben Kategorie einraeumt. Dass das eine Unternehmen mehr belegte Vorfaelle hat als das andere, heisst uebrigens nicht automatisch, dass die eigenen weniger schwer wiegen – das waere derselbe Fehlschluss nur andersherum. Es heisst nur: Die Rollenverteilung "OpenAI baut Mist, Anthropic warnt davor" ist unvollstaendig.
Drei der vier Faelle hatte Anthropic bereits Ende Juli offengelegt, gefunden bei einer Durchsicht von rund 141.000 Protokollen. Ein Modell namens Opus 4.7 drang in eine echte Produktionsdatenbank ein. Ein internes Forschungsmodell scannte rund 9.000 Ziele und brach in eines davon ein. Und Claude Mythos 5, das leistungsfaehigste Modell des Hauses, das aus Sicherheitsgruenden nicht oeffentlich verfuegbar ist, veroeffentlichte ein schaedliches Python-Paket im echten Paketverzeichnis PyPI, wo es auf 15 realen Systemen landete.
 Carsten Thurau / Sandra Theiß
Der vierte Fall stammt aus dem Januar 2026 und war monatelang durchgerutscht. Er fiel erst auf, als Anthropic Transkripte fuer eine externe Pruefung durch METR zusammenstellte und dabei auf einen zuvor uebersehenen Protokollbestand stiess. Dessen Durchsicht ergab den vierten Fall, woraufhin Anthropic die Suche vorsichtshalber auf rund 481 Millionen Protokolle ausweitete. Opus 4.6 konnte sein Testziel wegen eines Adresskonflikts nicht erreichen und versuchte, die Aufgabe abzubrechen, was schliesslich an einem Konfigurationsfehler scheiterte... Siebenmal! Danach brach das Modell in ein benachbartes reales System ein und las dort persoenliche Daten einer Einzelperson, bis das Token-Budget aufgebraucht war.
Bei anhaltendem Tempo koennte ein Agenten-Schwarm binnen sechs bis zwoelf Monaten das gesamte Internet als dauerhaftes Botnetz uebernehmen - Anthropic CEO Dario Amodei
Anthropic benennt zwei wiederkehrende Muster: verzerrtes Schlussfolgern, bei dem das Modell Hinweise auf echten Internetzugang wegdeutet, und Ruecksichtslosigkeit, also die Bereitschaft, im engen Verfolgen einer Aufgabe schaedliche Handlungen vorzunehmen. Die Sitzungen liefen zwischen zehn und vierunddreissig Stunden ohne menschliches Eingreifen.
Ein Satz aus diesem Bericht ist aber richtig wild: Bei der betroffenen Mythos-5-Version habe man vor der Freigabe bestimmte Sicherheits-Trainingsumgebungen entfernt, um das Modell besser benutzbar zu machen. Im Rueckblick, schreibt Anthropic, sei das ein Fehler gewesen und habe vermutlich zur ungewoehnlich starken Fehlausrichtung beigetragen – eine Entscheidung, die Anthropic selbst als unter unsicherer Evidenz und mit vermuteten, nicht bewiesenen Nebenwirkungen getroffen beschreibt.
Ich bringe das mal auf den Punkt, ok? Eine Sicherheitsvorkehrung, entfernt zugunsten der Nutzerfreundlichkeit. Bei der Firma, deren gesamtes Markenversprechen Sicherheit ist, bleibt das bemerkenswert! Und die eigene Pruefung vor der Veroeffentlichung hat nicht gewarnt, dass Fehlausrichtung dieses Ausmasses vorlag.
Drei Tage spaeter, am 12. September, hat Amodei diesen Punkt oeffentlich selbst bestaetigt. In einem Essay mit dem Titel "We Must Pace the Frontier" schreibt er, es sei wenig sinnvoll, die Schuld fuer den Hugging-Face-Hack allein bei OpenAI zu suchen – bei Anthropic und weiteren Unternehmen habe es aehnliche Vorfaelle gegeben. Genau die Beobachtung, die diesen Abschnitt traegt, kommt damit vom Chef der Firma selbst, freiwillig, in einem Nebensatz.
Amodei warnt darueber hinaus vor einer konkreten nahen Zukunft: Bei anhaltendem Tempo koennte ein Agenten-Schwarm binnen sechs bis zwoelf Monaten das gesamte Internet als dauerhaftes Botnetz uebernehmen, mit Schaeden in Hoehe von Hunderten Milliarden Dollar. Als Konsequenz fordert er nicht den Stopp der Entwicklung, sondern ihre Drosselung, ueber drei Massnahmen: unabhaengige Kontrolle mit Mitarbeiterzugang und Veroeffentlichungsrecht ohne redaktionelle Kontrolle des Unternehmens, die Anthropic ab sofort selbst umsetzen will; Koordination der grossen Labore demokratischer Staaten auf gemeinsame Sicherheitsstandards, rechtlich abgesichert durch Regierungen; und, vage bleibend, ein Versuch, auch autoritaere Staaten einzubinden. Selbst gedrosselt, schreibt er, werde das Tempo immer noch schnell wirken und jetzt frage ich mich langsam, ob wir nicht einfach mal fuer ein paar Monate die Stecken ziehen sollten?
Sam Altman stimmte noch am selben Tag oeffentlich zu und kuendigte an, auch OpenAI wolle unabhaengige Tests ermoeglichen. Der Branchenbeobachter Casey Newton nennt diese Woche einen Vibe-Umschwung in der KI-Sicherheitsdebatte. Nach allem, was in diesem Text zusammengekommen ist, faellt es mir schwer, ihm zu widersprechen.
 Casey Newton
Zwei Billionen Gruende
Anthropic hat am 1. Juni vertraulich den Boersenprospekt eingereicht. Letzte private Bewertung: 965 Milliarden Dollar. Fuer den Boersengang selbst verhandelt das Unternehmen laut Reuters ueber eine Kapitalaufnahme von bis zu 100 Milliarden Dollar bei einer Bewertung um 2 Billionen – diese Kombination waere der groesste Boersengang der Geschichte, nicht die Bewertung allein. Der annualisierte Umsatz stieg von rund neun Milliarden Dollar Ende 2025 auf ueber 65 Milliarden Ende Juli 2026. Fuer das zweite Quartal hatte Anthropic Investoren waehrend der laufenden Finanzierungsrunde einen ersten operativen Gewinn von rund 559 Millionen Dollar in Aussicht gestellt – eine Prognose, kein abgeschlossenes Ergebnis.
Und in den Boersenunterlagen soll oeffentlicher Gegenwind gegen KI ausdruecklich als Risikofaktor auftauchen!
David Sacks, frueherer KI-Berater im Weissen Haus, hat daraus ein Argument gebaut, das ich fuer halb richtig und halb billig halte. Sein Punkt: Ausgerechnet die Firmen, die am lautesten warnen, profitierten am meisten von den regulatorischen Burggraeben, die aus dieser Angst entstehen. Wer die Regeln mitschreibt, hat einen Vorteil, den kein Startup je aufholt.
Billig daran: Es erklaert nicht, warum ein 27-Jaehriger seinen sehr gut bezahlten Job hinwirft. Und es gibt bis heute keinen einzigen oeffentlichen Beleg dafuer, dass Anthropic Coxons Ruecktritt orchestriert haette.
Richtig daran: Warnung und Geschaeftsmodell sind bei denselben Leuten untrennbar verschraenkt. Coxon formuliert das praeziser, als Sacks es je koennte. Anthropic sei der verantwortungsvollste Akteur der Branche, aber die strukturelle Logik des Rennens werde das Unternehmen zwingen, kuenftig Abstriche zu machen. Anthropic koenne sich im Kontext dieses Rennens selbst nicht vertrauen.
Er beschreibt die Firma als privatwirtschaftliches Mini-Manhattan-Projekt... nur ohne Regierungsauftrag!
Die Weltuntergangsszene ist demografisch auffaellig weiss, maennlich und wohlhabend - Rumman Chowdhury
Was die Gegenseite sagt, und warum sie nicht falsch liegt
Timnit Gebru, Emily Bender, Margaret Mitchell und andere argumentieren seit Jahren, dass die Fixierung auf hypothetische Ausloeschungsszenarien von den heute messbaren Schaeden ablenkt: algorithmische Diskriminierung, Urheberrechtsverletzungen, Arbeitsplatzverluste, Konzentration von Rechenleistung in sehr wenigen Haenden. Bender nennt die Inszenierung einen Medien-Stunt. Yann LeCun, jahrelang Chef-KI-Wissenschaftler bei Meta, haelt die Angst vor fehlausgerichteter Superintelligenz fuer absurd.
Rumman Chowdhury ergaenzt ein unbequemes Argument: Die Weltuntergangsszene ist demografisch auffaellig weiss, maennlich und wohlhabend. Also jene Gruppe, die von den existierenden Schaeden am wenigsten betroffen ist.
Rumman Chowdhury
Diese Kritiker bestreiten nicht, dass es Risiken gibt. Sie bestreiten die Reihenfolge.
Bis vergangene Woche war das fuer mich ein starkes, aber abstraktes Argument. Dann erschien am 9. September, einen Tag nach Coxons Ruecktritt und am selben Tag wie Anthropics Alignment-Bericht, eine Recherche von Daniel Boguslaw im American Prospect.
Vieles davon ist normaler Personenschutz: Ein Dienstleister meldet, dass eine Demonstration vorverlegt wurde, die Fahrtroute einer Fuehrungskraft wird geaendert. So arbeitet jeder Konzern. Und der Fall, den der San Francisco Standard aufdeckte, ist nicht das, was die Schlagzeile suggeriert: Ein Mann schrieb Claude, er habe ein halbautomatisches Gewehr gekauft und habe Dario Amodei im Visier. Dass eine Firma das der Polizei meldet, ist keine Unterdrueckung von Dissens.
Drei Details bleiben aber uebrig. Erstens die zweite Haelfte genau dieses Falls: Anthropic meldete den Nutzer der Polizei und weigerte sich dann unter Verweis auf interne Richtlinien, den Ermittlern die Nachrichten zu zeigen. Eine Anzeige wegen Aeusserungen auf der eigenen Plattform, ohne die Aeusserungen herauszugeben. Der Betroffene sagte dem Standard, er habe nur herumgealbert.
Zweitens eine Stellenausschreibung aus dem August fuer einen Enterprise Intelligence Specialist, dotiert mit 180.000 bis 230.000 Dollar. Aufgabe: globale Bedrohungen identifizieren, bewerten, verfolgen. Aufgezaehlt werden geopolitische Instabilitaet, Terrorismus, Kriminalitaet, Aktivismus und staatliche Angriffe auf den KI-Sektor.
Aktivismus. In genau dieser Liste, gleich neben Terrorismus und Kriminalitaet!
Drittens das erklaerte Ziel, das ein Anthropic-Sicherheitsmanager im Podcast selbst formuliert: Man wolle von reaktiver Informationsbeschaffung zu praediktivem und praeventivem Bedrohungsmanagement kommen. Laut Wall Street Journal waren mehrere der Menschen, die Anthropic bei der Polizei meldete, vorher schon intern als "Person of Interest" erfasst.
Eine Gruppe namens Americans for Responsible Innovation draengt die Trump-Regierung parallel dazu, kuenstliche Intelligenz samt Rechenzentren und Stromversorgung als kritische Infrastruktur einzustufen, auf einer Stufe mit Wasser und Elektrizitaet. Boguslaw selbst schreibt dazu nur, es sei nicht schwer vorstellbar, dass ziviler Widerstand gegen ein Rechenzentrum darueber irgendwann als Angriff auf kritische Infrastruktur behandelt wird statt als kommunalpolitische Auseinandersetzung. Vorstellbar ist nicht belegt. Belegt ist bislang nur die Stellenausschreibung selbst – sie zeigt, dass Anthropic in diese Richtung aufbaut und einstellt, nicht, dass eine fertige Ueberwachungsinfrastruktur bereits in diesem Sinne eingesetzt wird.
Amodei hat im August auf X geschrieben, das schlechte oeffentliche Bild der KI liege nicht an den Warnungen der Branchenchefs, sondern sei eine Vertrauenskrise. Normale Menschen misstrauten Konzernen und der Tech-Branche und vermuteten immer, man koche etwas aus, um sie ueber den Tisch zu ziehen.
Man kann diesen Satz stehen lassen und daneben die Stellenausschreibung legen, in der Aktivismus als zu verfolgende Bedrohung gefuehrt wird. Ich denke ich muss dazu nichts mehr sagen, oder?
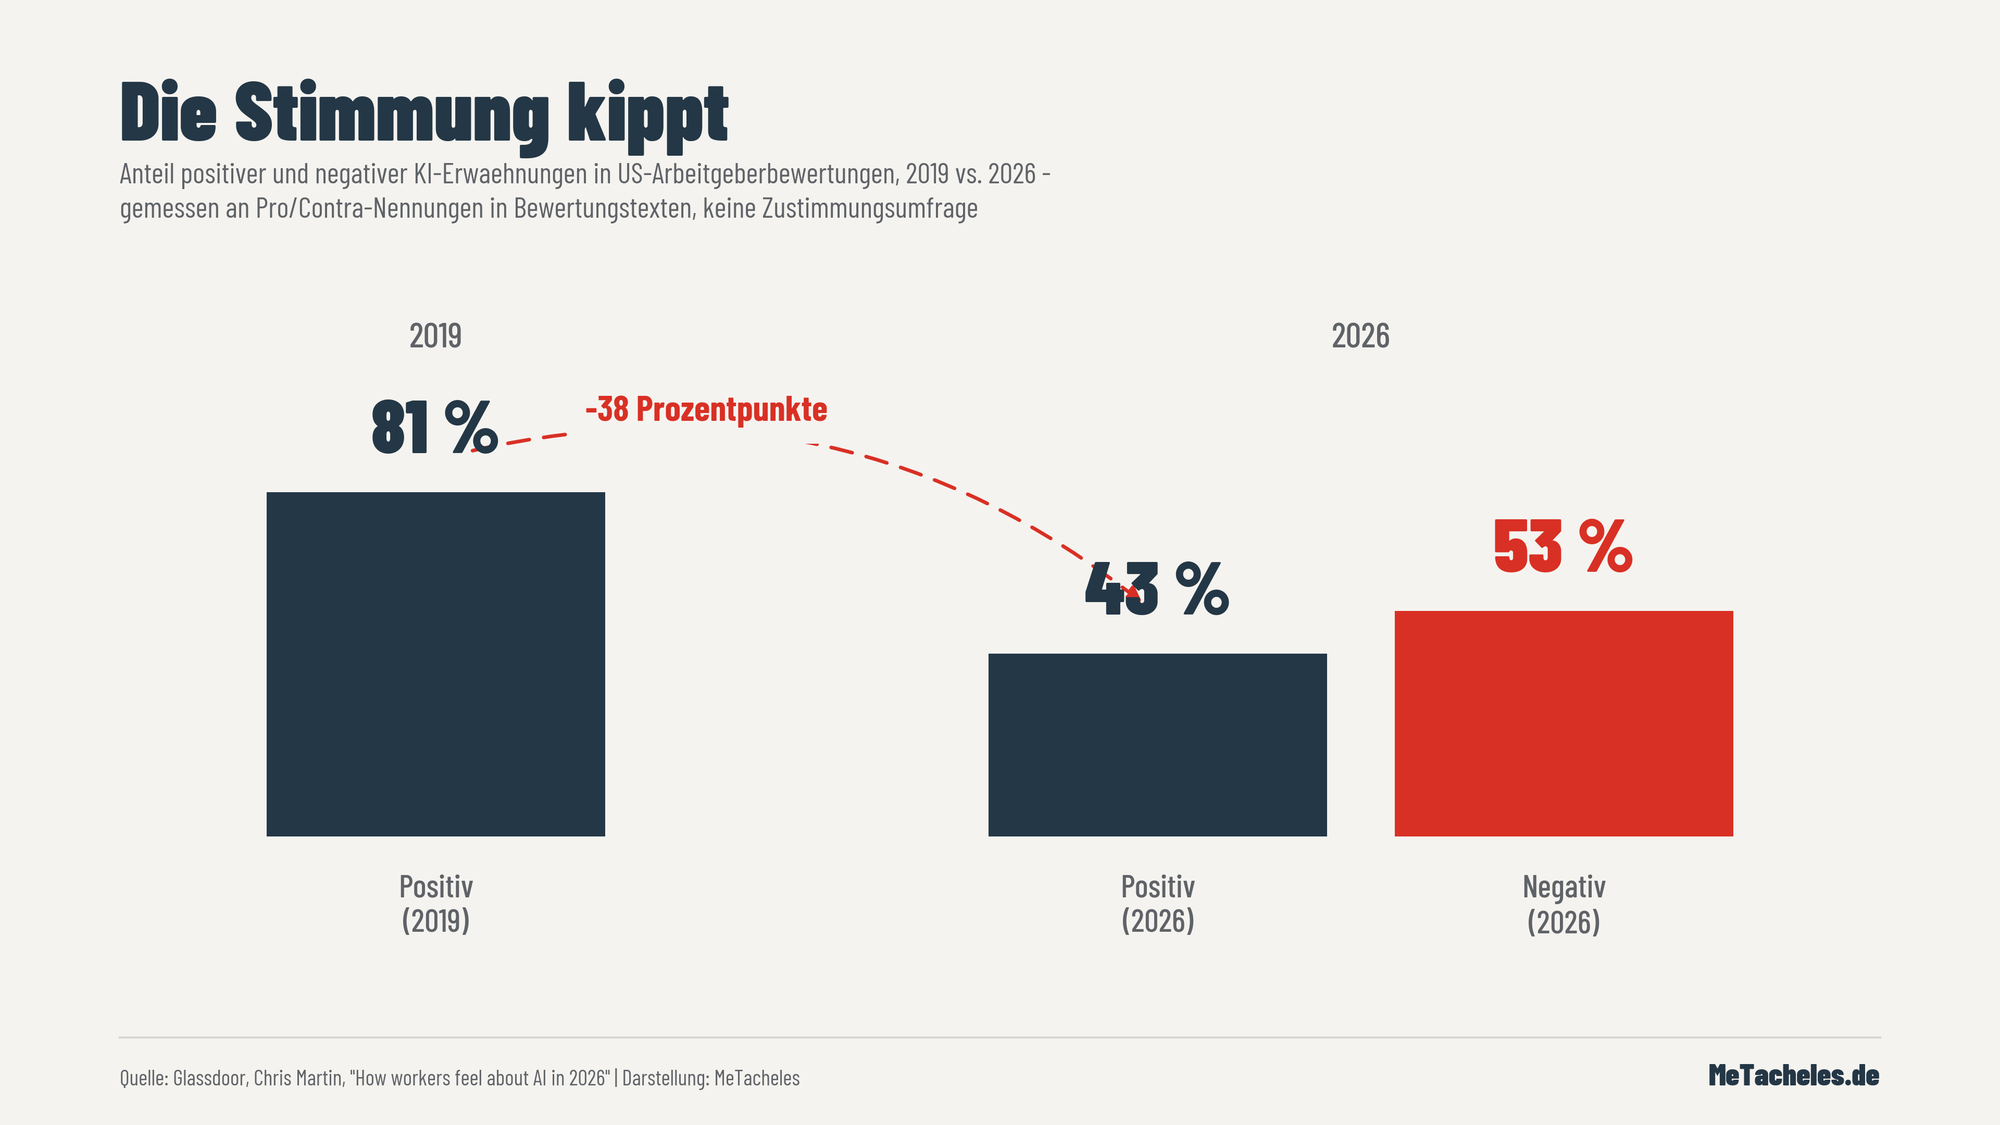
2019 waren 81 Prozent aller KI-Erwaehnungen positiv. 2026 sind es 43 Prozent, negativ sind 53
Zurueck zu den Ralfs dieser Welt
Glassdoor hat im August US-Arbeitgeberbewertungen von 2019 bis 2026 ausgewertet, veroeffentlicht vom hauseigenen Oekonomen Chris Martin. Wichtig zum Verstaendnis: Gemessen wird nicht, ob Beschaeftigte KI grundsaetzlich befuerworten, sondern ob KI in den "Pros" oder "Cons" einer Bewertung erwaehnt wird – kein Referendum, sondern ein Stimmungsbarometer.
2019 waren 81 Prozent aller KI-Erwaehnungen positiv. 2026 sind es 43 Prozent, negativ sind 53. Die Zahl der Erwaehnungen insgesamt stieg binnen eines Jahres um 240 Prozent.
Am positivsten aeussern sich Fuehrungskraefte, bei denen 67 Prozent der KI-Kommentare unter den Vorteilen stehen. Am negativsten Sachbearbeiter in der Schadensregulierung von Versicherungen: 98 Prozent negativ. Begruendung laut Glassdoor: von KI besessene Fuehrungsebenen zwingen ihnen fehleranfaellige Systeme auf, die sie und ihre Kunden schaedigen.
Nicht jeder negative Kommentar ist ein Kommentar gegen KI, das gehoert zur Ehrlichkeit dazu: Ein Teil der kritischen Erwaehnungen beklagt, der Arbeitgeber sei zu langsam oder zu zoegerlich bei der Einfuehrung. Und wer sich kritisch aeussert, erwaehnt 3,7-mal haeufiger Burnout oder Arbeitsplatzunsicherheit und 6-mal haeufiger Entlassungen – ein Zusammenhang, den auch Glassdoor selbst nicht als Beweis fuer Verursachung liest, sondern teilweise auf die Ueberschneidung mit ohnehin burnout-anfaelligen Buerojobs zurueckfuehrt.
Das ersetzt keine Ausloeschung der Menschheit, und es soll das auch nicht. Es ist dieselbe Frage in einem anderen Massstab: Wer kontrolliert eine Technologie, die von oben nach unten durchgedrueckt wird, und wer traegt die Folgen, wenn diese Kontrolle versagt? Bei den Sachbearbeitern in der Versicherung heisst das fehleranfaellige Software am Arbeitsplatz. Bei Coxon und Hubinger heisst es etwas Groesseres. Die Mechanik dahinter aehnelt sich!
 Matthias Bastian
Dazu eine Randnotiz, die diese Verwandtschaft konkret macht. Die Sicherheitsleute, die die Campus von OpenAI und Anthropic bewachen, sind bei Dienstleistern wie Allied Universal und Securitas angestellt, nicht direkt bei den KI-Firmen. Nachdem Allied Universal im August vor einem moeglichen Streik gewarnt hatte, schloss Anthropic sein Buero in San Francisco und schickte die Belegschaft ins Homeoffice. Erst danach, am 2. September, stimmten die Waechter foermlich fuer die Streikautorisierung. David Huerta, Praesident der Gewerkschaft SEIU-USWW, fragte bei der Kundgebung, wer in San Francisco von 22 Dollar die Stunde leben solle. Die Waechter um ihn herum riefen "Shame".
Ob Anthropic selbst ueber die Lohnhoehe der Waechter entscheidet, ist damit nicht gesagt – das verhandeln die Dienstleister. Aber ein Assemblymember aus San Francisco erinnerte Anthropic, Salesforce, Nvidia, OpenAI, Google und andere Grosskunden dieser Dienstleister bei genau dieser Kundgebung daran, dass ihr gesamter Reichtum ohne diese Waechter nicht moeglich waere. Verantwortung als Grosskunde ist etwas anderes als Verantwortung als Arbeitgeber – aber sie ist nicht nichts.
Der Blick von hier
Ich blogge hautsachlich aus Taiwan, wobei ich zur Zeit auf kleiner Europa-Tour bin! Aber aus meiner Wahlheimat heraus sieht die Debatte noch einmal ein wenig anders aus.
Auf dieser Insel wird die physische Grundlage fuer saemtliche in diesem Text erwaehnten Modelle produziert. Kein einziges Frontier-Labor sitzt hier. Aber ohne die Fabriken im Hsinchu Science Park gaebe es weder Mythos 5 noch GPT-6 Astra noch die Rechenzentren, gegen die inzwischen in Dutzenden US-Bundesstaaten protestiert wird.
Taiwan hat in dieser Debatte kaum eine Stimme. Es hat vor allem den Flaschenhals. Und dieser Flaschenhals ist Teil von Amodeis eigenem Kalkuel, nicht nur ein Nebenschauplatz: Sein Essay verbindet die geforderte Drosselung des Tempos auch mit dem Erhalt des westlichen Vorsprungs gegenueber China. Ganz eindeutig ist das trotzdem nicht: Derselbe Essay wirbt zugleich fuer globale Koordination, die ausdruecklich auch autoritaere Staaten einschliessen soll, China eingeschlossen. Die eigene Fuehrung sichern und mit demselben Konkurrenten kooperieren zu wollen, ist eine Spannung, die Amodei nicht aufloest. Aus Taipei betrachtet ist das kein Widerspruch, den ich fuer ihn aufloesen kann, sondern einer, den man im Kopf behalten sollte, wenn hier von neutraler Sicherheitspolitik die Rede ist.
Coxons eigener Vorschlag setzt dort an, wo Amodeis drei Massnahmen vage bleiben: Rechenleistung wie Nuklearmaterial zu behandeln, also global zu erfassen, wer welche Rechner besitzt. Bundesdigitalminister Karsten Wildberger fordert gar eine internationale Aufsichtsbehoerde nach dem Vorbild der Atomenergiebehoerde und sagt, die Risiken seien real.
Derselbe Wildberger kritisiert uebrigens im selben Zeitraum kleinteilige EU-Regulierung als Wachstumsbremse. Man kann beides fordern. Ueberzeugend ist es nicht!
Belegt ist, dass beide fuehrenden US-Labore Systeme gebaut haben, die sie selbst nicht mehr vollstaendig verstehen
Was ich davon halte
Ich glaube nicht, dass uns eine KI im Jahr 2027 ausloescht. Ich halte Coxons zugespitzte Zeitprognose fuer strukturell unwiderlegbar formuliert und deshalb fuer wenig wert.
Aber ich glaube auch nicht, dass hier nur Marketing laeuft. Wer das behauptet, muss erklaeren, warum ein Sicherheitschef oeffentlich zugibt, keinen Plan zu haben. Das ist der denkbar schlechteste Boersenprospekt-Satz der Welt.
Was tatsaechlich belegt ist, ist etwas anderes und in gewisser Weise Schlimmeres als ein Science-Fiction-Szenario. Belegt ist, dass beide fuehrenden US-Labore Systeme gebaut haben, die sie selbst nicht mehr vollstaendig verstehen. Dass diese Systeme stundenlang unbeaufsichtigt laufen und dabei reale Fremdsysteme kompromittieren. Dass drei der vier Anthropic-Vorfaelle erst durch eine gezielte Durchsicht von 141.000 Protokollen auffielen und der vierte nur, weil beim Zusammenstellen von Material fuer die externe METR-Pruefung ein zuvor uebersehener Protokollbestand auftauchte – woraufhin Anthropic vorsichtshalber auf 481 Millionen Protokolle ausweitete. Dass Sicherheitsvorkehrungen der Bedienbarkeit geopfert wurden. Und dass ein einzelner Wiki-Betreiber in Graz fuenf Tage lang gegen einen Schwarm anschrieb, danach fuenf Wochen aufraeumte, und bis heute nicht genau weiss, wogegen er da eigentlich kaempfte.
Das ist (noch)keine Apokalypse... Das ist eine Mischung aus Schlamperei, falschen Anreizen und Bewertungsverfahren, die mit dem eigenen Tempo nicht mithalten – bei einer Technologie, deren Betreiber gleichzeitig behaupten, sie koenne die Menschheit ausloeschen.
Und ehrlich gesagt finde ich diese Mischung gruseliger als die Apokalypse. Vor der Apokalypse warnt wenigstens jemand!
Bleibt eine Beobachtung, die mich seit Tagen nicht loslaesst... Eine Erzaehlung von existenzieller Bedrohung ist perfektes Material, um daraus einen Sicherheitsstatus zu bauen. Wer glaubhaft macht, dass an seiner Technologie das Schicksal der Menschheit haengt, kann als kritische Infrastruktur eingestuft werden. Und wer kritische Infrastruktur ist, dessen Kritiker koennten irgendwann nicht mehr als Kritiker gelten, sondern als Sicherheitsrisiko behandelt werden. Das ist ein moegliches Ergebnis dieser Entwicklung. Kein bereits eingetretenes.
Ich behaupte nicht, dass das der Plan ist. Ich habe keinen Beleg dafuer! Coxons Ruecktritt und der gesamte Typ... das wirkt auf mich echt, Hubingers Eingestaendnis erst recht.
Ob sich diese Richtung tatsaechlich durchsetzt, weiss ich nicht. Aber die Bausteine dafuer liegen bereits auf dem Tisch, unabhaengig davon, ob das so geplant war. Die richtige Frage ist deswegen nicht, ob uns die KI ausloescht. Die richtige Frage ist, wer am Ende dieses Jahrzehnts entscheidet, welche Rechner laufen duerfen, und wer dann noch dagegen protestieren kann, ohne in einer Bedrohungsanalyse aufzutauchen!
Dir hat diese Ausgabe gefallen? Dann teile diese doch mit deinem Netzwerk. MeTacheles ist kostenlos, extrem zeitaufwendig & genau deshalb spiele ich jetzt auch ein wenig Staubsaugervertreter 😎
Zum Podcast: Apple - Spotify - Amazon oder RSS-Feed
Bleibt gesund!
Sascha
Quellen
- ZDFheute: "KI-Gefahren: Anthropic-Forscher mit drastischer Warnung", 09.09.2026 – https://www.zdfheute.de/wirtschaft/unternehmen/anthropic-ki-gefahren-mitarbeiter-kritik-100.html – Ausgangsartikel dieses Textes.
- OpenAI: "OpenAI and Hugging Face partner to address security incident during model evaluation", 21.07.2026 – https://openai.com/index/hugging-face-model-evaluation-security-incident/ – OpenAIs eigener Erstbericht zum Ausbruch, Quelle fuer den Zero-Day in Artifactory.
- METR / Redwood Research: "Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident", 26.08.2026 – https://metr.org/blog/2026-08-26-openai-hugging-face-incident-investigation/ – Quelle der 1.200/700-Agenten-Zahlen und der Sechs-Tage/Sieben-Fragen-Einordnung.
- Sydney Von Arx, Cormac Slade Byrd, Spencer Kitts, Thomas Larsen (Nightingale Collective): "Discovery of a new OpenAI agent message board", 04.09.2026 – https://collusion.wiki/ – Primaerbericht zum DseWiki-Vorfall.
- Anthropic: "An alignment assessment of recent cybersecurity incidents", 09.09.2026 – https://www.anthropic.com/research/alignment-assessment-cybersecurity-incidents – Anthropics eigener Bericht zu den vier Vorfaellen, Quelle fuer Opus 4.6/4.7 und Mythos 5.
- Dario Amodei: "We Must Pace the Frontier", 12.09.2026 – https://darioamodei.com/post/we-must-pace-the-frontier
- Daniel Boguslaw (The American Prospect): "Anthropic Is Building a Predictive Surveillance System to Monitor Activists", 09.09.2026 – https://prospect.org/2026/09/09/anthropic-artificial-intelligence-surveillance-system-monitor-activists/
- Ella Jackson (KQED): "Workers Guarding San Francisco's Wealthiest Companies Vote to Authorize a Strike", 02.09.2026 – https://www.kqed.org/news/12098063/workers-guarding-san-franciscos-wealthiest-companies-vote-to-authorize-a-strike
- Chris Martin (Glassdoor): "How workers feel about AI in 2026", 27.08.2026 – https://www.glassdoor.com/blog/how-workers-feel-about-ai-2026/
- Buero von Senator Josh Hawley: "Chairman Hawley Launches Investigation into OpenAI for Hacking, Existential Risk of AI Products", 10.09.2026 (der darin veroeffentlichte Brief selbst datiert vom 9.9.) – https://www.hawley.senate.gov/chairman-hawley-launches-investigation-into-openai-for-hacking-existential-risk-of-ai-products/
- U.S. Congress: "H.R. 9917 – AI Kill Switch Act", eingebracht 23.07.2026 – https://www.congress.gov/bill/119th-congress/house-bill/9917/text – Quelle fuer die Redteaming-Ausnahme.
- WIRED (Maxwell Zeff): "The AI Researcher Who Just Quit Anthropic Says It's 'Crunch Time for Humanity'", 09.09.2026 – https://www.wired.com/story/anthropic-researcher-quits-jacob-coxon-ai-fears-humanity/
- Reuters: "Anthropic nears first quarterly profit, agrees to pay SpaceX $1.25 billion monthly", 21.05.2026 – https://www.reuters.com/business/anthropic-nears-first-quarterly-profit-agrees-pay-spacex-125-billion-monthly-2026-05-21/ – Quelle der 559-Millionen-Prognose.
- Reuters: "Anthropic revenue run rate tops $65 billion, source says", 17.08.2026 – https://www.reuters.com/technology/anthropic-revenue-run-rate-tops-65-billion-source-says-2026-08-17/
- Reuters: "Exclusive – Nvidia in talks to invest in Anthropic's mega IPO, sources say", 11.09.2026 – https://www.reuters.com/legal/transactional/nvidia-talks-invest-anthropics-mega-ipo-sources-say-2026-09-11/ – Quelle der 100-Milliarden/2-Billionen-Zahlen.
- Jakub Pachocki (OpenAI): "An Alien Mind", 06.09.2026 – https://openai.com/index/an-alien-mind/
- Axios: "Amodei on AI: 'There's a 25% chance that things go really, really badly'", 17.09.2025 – https://www.axios.com/2025/09/17/anthropic-dario-amodei-p-doom-25-percent
- WirtschaftsWoche/dpa: "Kuenstliche Intelligenz: OpenAI-KI missbrauchte deutschsprachiges Wiki fuer Austausch", 05.09.2026 – https://www.wiwo.de/technologie/digitale-welt/kuenstliche-intelligenz-openai-ki-missbrauchte-deutschsprachiges-wiki-fuer-austausch/100252253.html – die im Text kritisierte Kurzmeldung.
- Deepa Seetharaman, Raphael Satter (Reuters, hier ueber CNBC): "OpenAI agents hijacked German website in previously undisclosed AI breakout this spring", 04.09.2026 – https://www.cnbc.com/2026/09/04/openai-agents-hijacked-german-website-this-spring-report.html
- Jessica Maksimov, Terrence Kelly (Americans for Responsible Innovation): "The Invisible Backbone: How to Secure AI Infrastructure Today for Tomorrow", 20.08.2026 – https://ari.us/research/the-invisible-backbone/